OpenViking:把 Agent 上下文放进一套文件系统
OpenViking:把 Agent 上下文放进一套文件系统
蔡坨坨转载请注明出处❤️
作者:测试蔡坨坨
原文链接:caituotuo.top/8ad04a89.html
从留住记忆,到接住脉络
你好,我是测试蔡坨坨。
上一篇,我们聊到了 RDS ContextDB:它试图把 Agent 在任务中形成的事实、判断和反馈沉淀下来,让一场会话里的经验,不至于随着任务结束而烟消云散。
这一篇继续聊上下文记忆,只是换一个角度。
如果说 ContextDB 更像是在帮 Agent 留住工作记忆,把一次次任务里的事实、判断和反馈慢慢沉淀;那么 OpenViking 选择的方式,则更接近研发团队熟悉的秩序:把资源、记忆和 Skills 放进一套虚拟文件系统里,让不同 Agent 可以循着同一条路径,查找、读取、复用上下文。
这段时间用 Agent 参与研发协作,感受越来越明显:工具越多,分工越细,任务流转越快,上下文也越容易散。
需求在群聊中酝酿,代码由 Coding Agent 推进,结论再回到文档中沉淀。看起来各司其职、环环相扣,但真正支撑判断的项目背景、历史取舍和经验脉络,却未必能顺着流程一起流转。
所以这一篇,我想聊聊 OpenViking。
它想做的不是替 Agent 完成任务,而是给 Agent 们铺一条共同的上下文路径:让资源有处可寻,让记忆有迹可循,让经验不至于各自为政、散落四方。
不是另起炉灶,而是同归一径
OpenViking 是一个面向 AI Agent 的开源上下文数据库。
它并不打算替代 Claude Code、Codex 或其他 Agent 去执行任务,也不是在现有工具之外另起炉灶。它更像是站在这些 Agent 背后,替它们安放一层可以共同读取、持续演进的上下文底座。
换句话说,Agent 负责冲锋陷阵,OpenViking 负责铺路架桥。一个在前台执行任务,一个在后台整理脉络;一个处理眼前问题,一个保存来龙去脉。
官方文档对它的定位也很明确:通过文件系统范式统一管理 Agent 所需要的上下文,包括记忆、资源和技能,并支持分层供给与自我迭代。
OpenViking 管理的 Context 主要分成三类:
- Resource 是项目文档、代码仓库、网页、FAQ 和团队规范。它们更像项目里的“案卷”和“典籍”,白纸黑字、有章可循,生命周期相对稳定,适合保存长期可复用的知识与规则。
- Memory 是用户偏好、历史判断、任务经验、执行轨迹和工具使用经验。它们更像协作过程中留下的“笔记”和“批注”,有些来自排查现场,有些来自取舍瞬间,虽然零散,却往往最能解释为什么当时这样做。
- Skill 是可以重复使用的工作方法、工具能力或 MCP 相关能力。它们更像被整理成册的方法论,把常用流程和固定动作沉淀下来,让 Agent 后续可以按图索骥、照章办事。
这三类内容都通过 viking:// URI 组织起来。对 Agent 来说,它们不再是一堆散落各处的资料碎片,而更像一套有路径、有层级、有归处的虚拟文件系统。
1 | viking:// |
Agent 可以用 ls、tree、find、read、abstract、overview 这类接近文件系统的方式浏览上下文。它面对的不再只是一个输入关键词、返回若干片段的黑盒检索接口,而是一套可以循序渐进、由浅入深的上下文目录。
1 | client.find(query="用户认证") # 语义搜索 |
这个设计很适合研发场景。
目录本身就在表达项目结构。Agent 找到一个结果后,还能顺藤摸瓜,继续查看同目录下的相关资料:从项目到模块,从文档到代码,从摘要到细节。上下文不再是互不相干的搜索结果,而是有来处、有位置,也有前后关系。
所以,OpenViking 的重点不是再做一个聊天入口,也不是再造一个 Agent。
它更像是给不同 Agent 搭了一座共同的书架:资源各归其位,记忆有迹可循,Skills 按需取用。Agent 负责向前推进,OpenViking 负责把散落的上下文收拢起来,让后来者有路可走,有据可查,有经验可承接。
不是囫囵吞下,而是循层取义
把上下文统一存起来,并不意味着每次都要一股脑塞给模型。
资料少的时候,全量读取还能勉强应付;资料一多,粗暴读取就会变成另一种负担:既挤占上下文窗口,也带来无关噪声。看似给得更多,实际反而让 Agent 更难抓住重点。
OpenViking 的处理方式,是在写入时把内容拆成三个层级,让 Agent 可以由浅入深、按需取用:
L0 Abstract 是摘要层,正文上限较短,主要用于向量搜索和快速过滤。它像目录上的一句提要,先帮助 Agent 判断“这里值不值得看”。
L1 Overview 是概览层,负责呈现结构、重点和使用场景,可以用于精排、内容导航,以及制定下一步检索计划。它不像 L0 那样点到为止,也不像 L2 那样事无巨细,更像一份导读,让 Agent 知道接下来该往哪里走。
L2 Detail 是详情层,保存完整内容。只有当摘要和概览已经证明这份资料确实相关时,Agent 才继续读取原文细节。
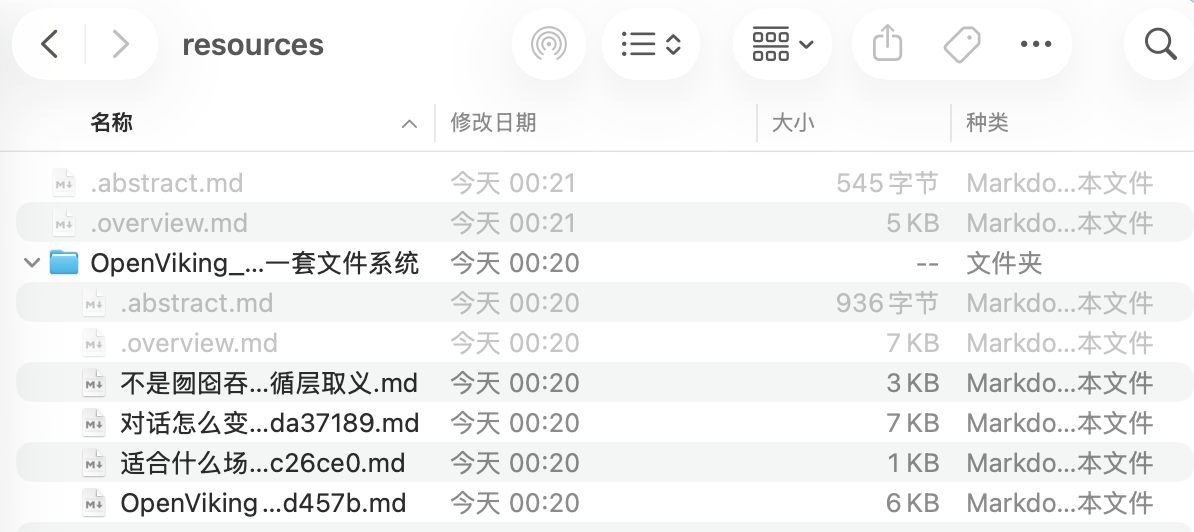
官方文档里也提到,目录通常也会有自己的 L0 和 L1。也就是说,Agent 可以先判断哪个目录相关,再逐层深入到具体文件。它不必一开始就打开完整文档,而是先看方向,再看结构,最后才看原文。
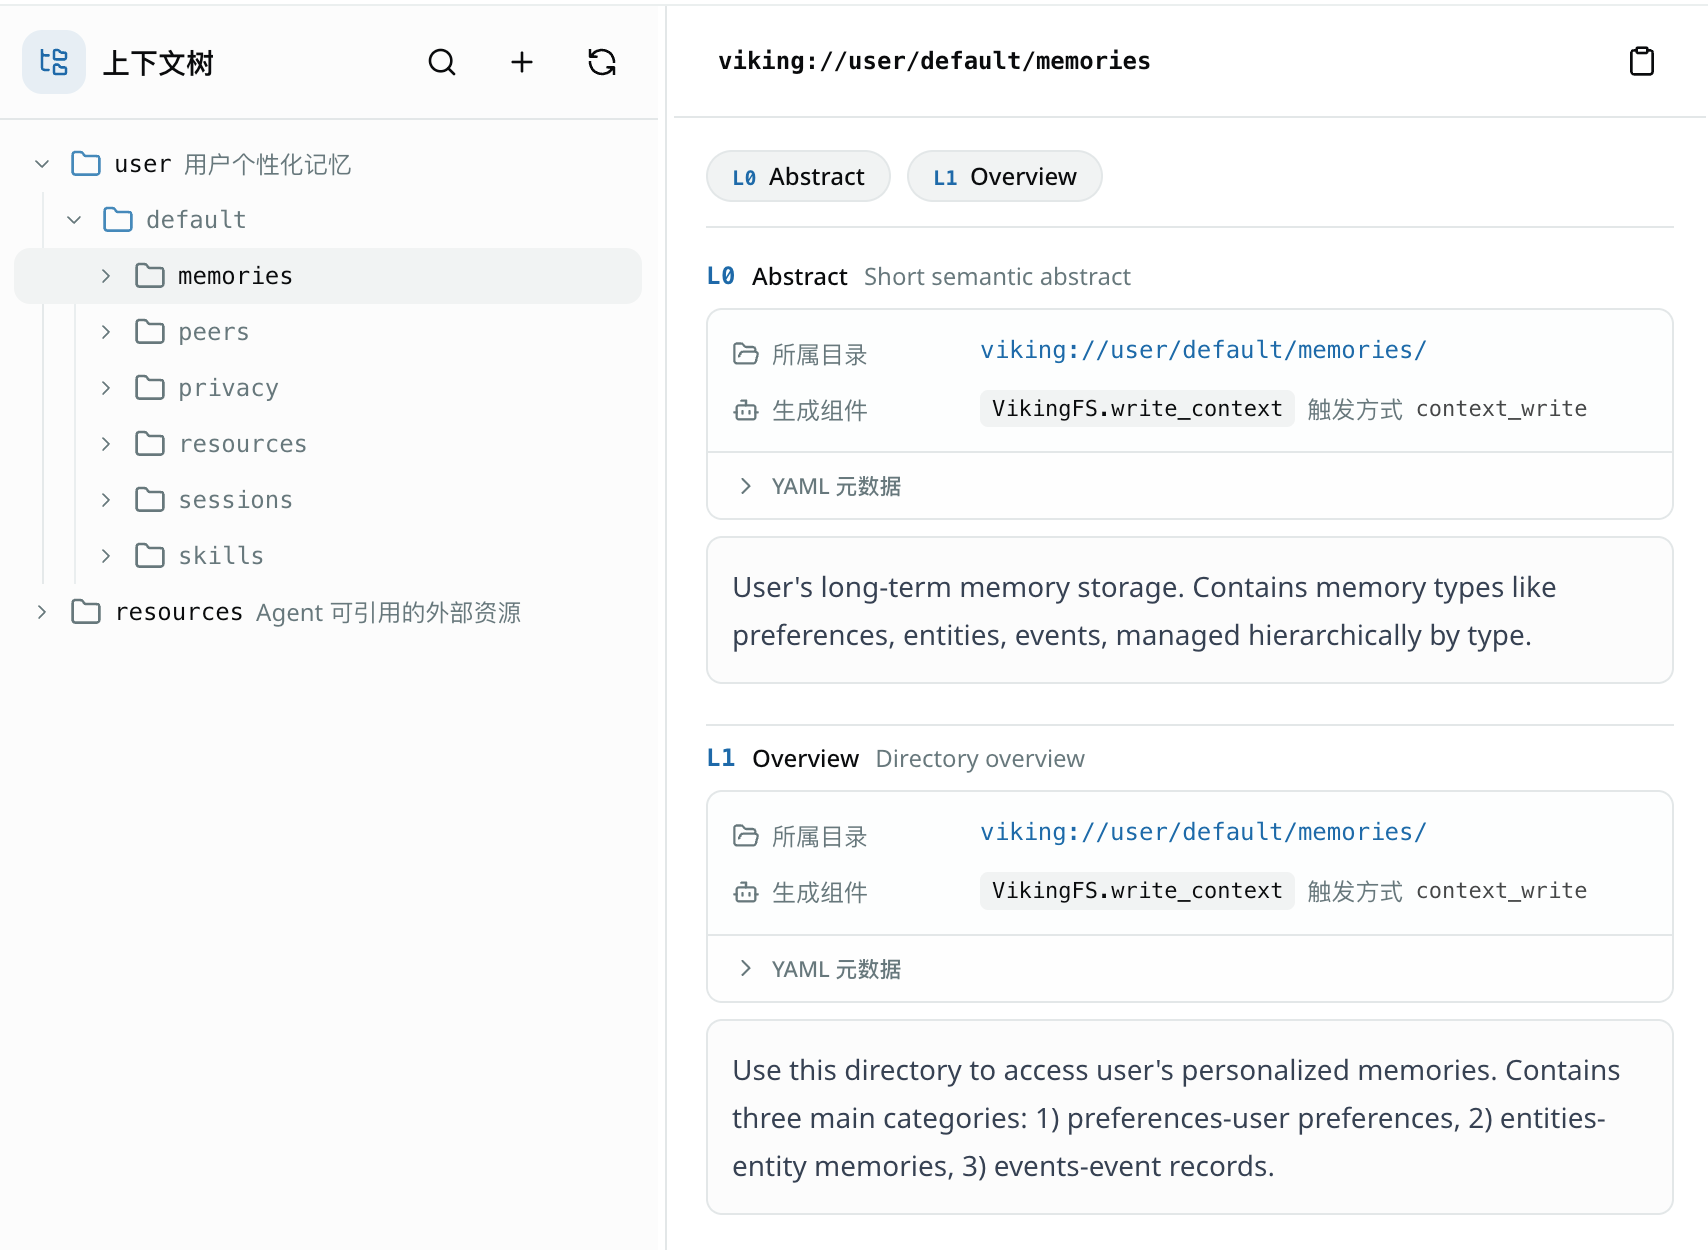
这种设计的好处在于:上下文不是被一次性“灌”进模型,而是被有序地递给 Agent。
这也是 OpenViking 和普通 RAG 很不一样的地方。
普通 RAG 更像是把文档切成一片片平铺的 chunks,再通过相似度从全局里捞出若干结果。OpenViking 则更强调上下文所在的位置,以及上下文之间的结构关系。
它不只是在问“哪个片段最像当前问题”,还会继续判断“这个片段属于哪里,它旁边还有什么,它上一级目录又说明了什么”。
官方文档把这个过程称为目录递归检索:先通过意图分析生成检索条件,再用向量检索定位高分目录;进入目录后继续做二次检索,如果还有子目录,就继续向下递归,最后再汇总最相关的上下文。
这个过程更接近人查资料的习惯:先找项目,再进模块;先看目录,再翻正文;先辨方向,再取细节。不是在满地碎片里碰运气,而是沿着已有结构顺藤摸瓜。
所以,OpenViking 的重点不是让 Agent 记住所有内容,而是让它知道该去哪里找、该读到哪一层、该在什么时候停下来。
上下文有了层次,检索才不至于大海捞针;内容有了路径,经验才不会无处可寻。
不是雾里看花,而是有迹可循
上下文系统最怕的,不是没有召回内容,而是看起来召回了内容,却说不清它为什么会被召回。
传统 RAG 出错时,我们常常只能看到几个相似度分数。分数高不代表答案一定对,分数低也不一定说明资料无关。问题到底出在文档切分、索引质量、召回策略、精排逻辑,还是用户的问题本身表达不清,很多时候都只能靠猜。
OpenViking 的文件系统范式,在这里多了一层好处:检索路径可以被保留下来。官方文档提到,系统会记录目录浏览、文件定位等轨迹,用来帮助开发者观察检索链路、排查问题来源。
这对研发团队很重要。
因为 Agent 回答错了,不一定只是模型能力不够,也可能是它找错了目录、读错了层级,或者根本没有拿到真正关键的上下文。如果只看最后答案,很容易把所有问题都归咎于模型;但如果能看到检索轨迹,就可以顺着路径往回查,找到问题究竟出在哪一环。
有了这些轨迹之后,团队可以回头看:它先查了哪个目录,为什么进入这个路径,读取的是摘要、概览,还是完整内容;是方向一开始就偏了,还是中途选错了文件;是资料本身不完整,还是检索策略没有命中重点。
这样一来,调试上下文就不再是雾里看花,也不再完全依赖经验猜测。
Agent 每一次查找,都有路可循;每一次召回,都有迹可查。上下文从黑箱里走出来,团队才知道该优化资料、调整索引,还是重新设计问题。
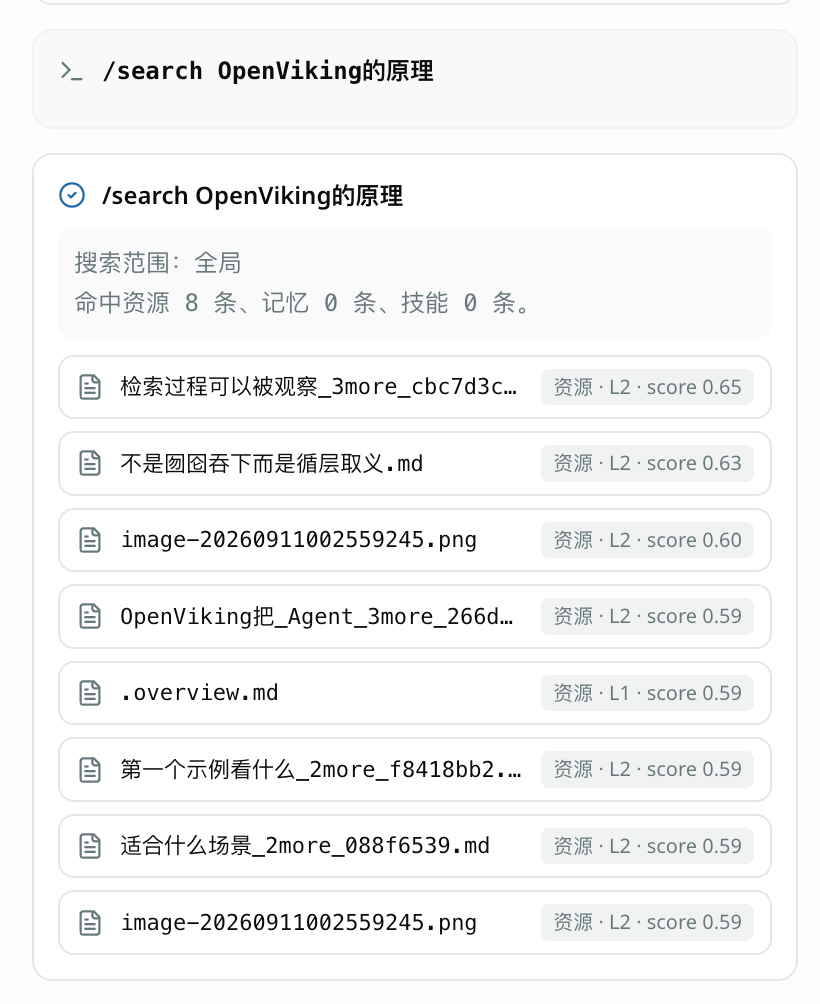
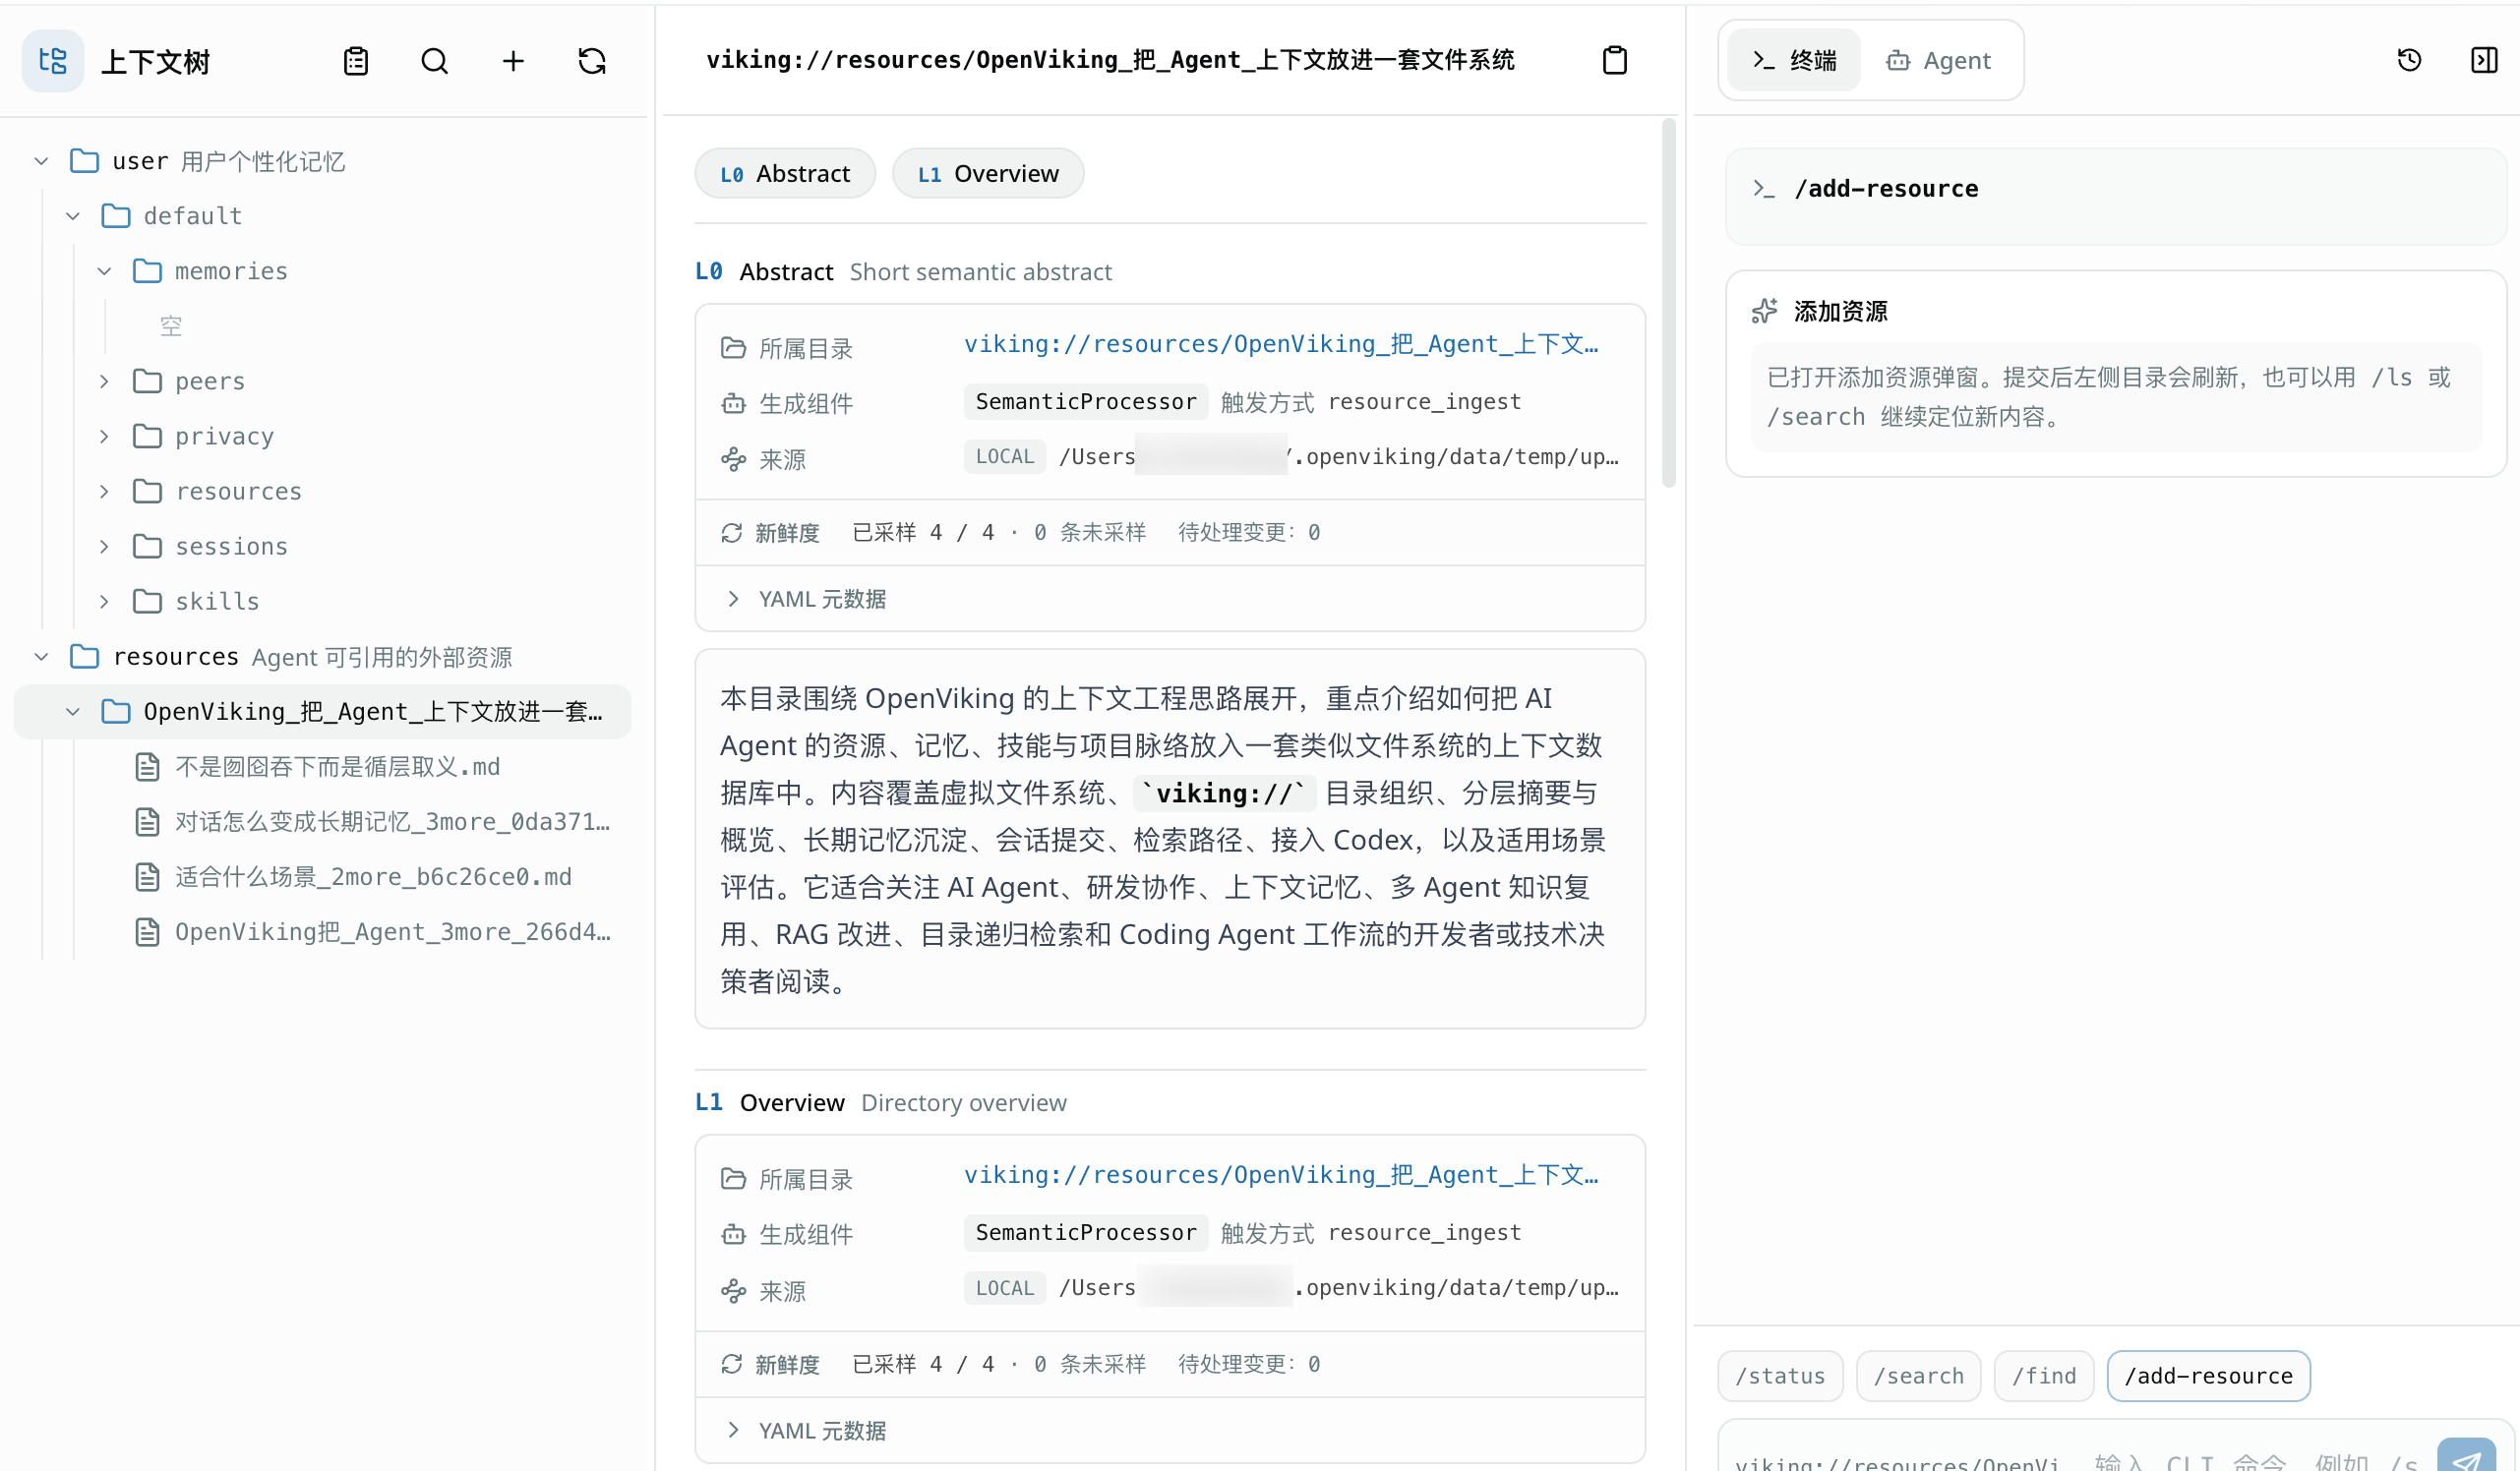
第一张图可以确认检索命中和分层结果,第二张图则更适合继续查看资源来源、摘要和内容状态。排查时有这两层信息,就不用只盯着最后答案猜问题。
不是人走茶凉,而是余脉长存
一次任务结束后,真正消失的往往不只是会话窗口,还有那些刚刚形成的判断、路径和经验。
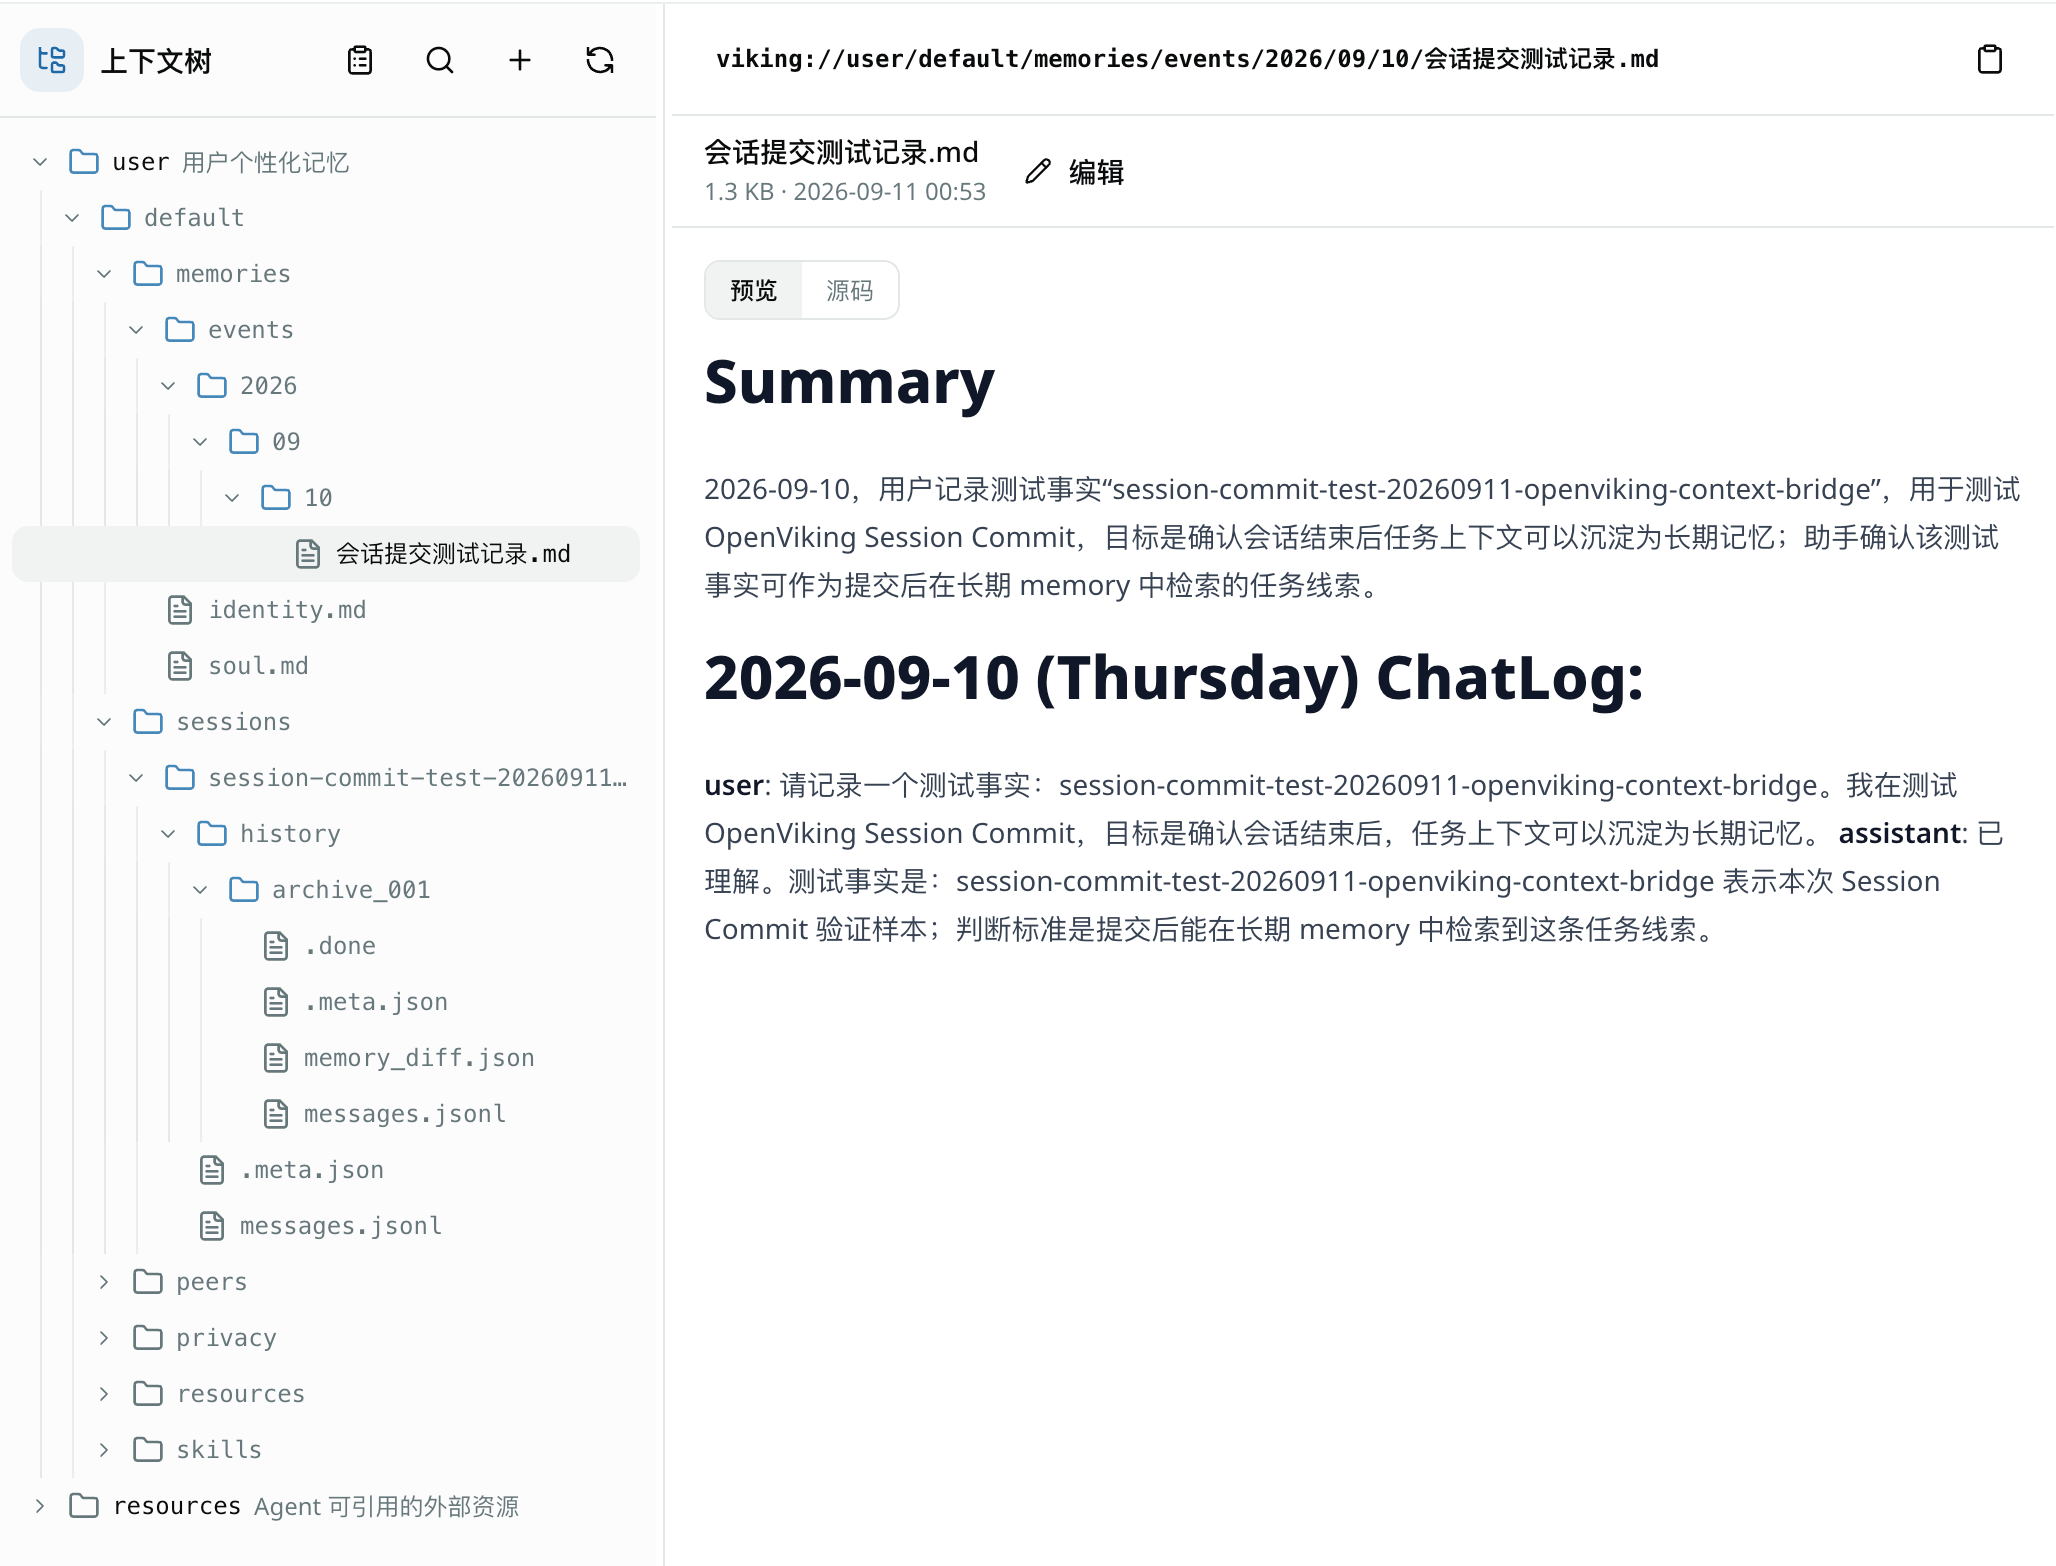
OpenViking 提供的 Session Commit,就是为了把这部分过程继续沉淀下来。会话可以结束,但任务里的上下文不必随之散场;人可以换入口继续协作,但前一轮留下的线索不该就此断线。
按官方说明,Session 提交后,系统会异步分析任务执行结果与用户反馈,并根据记忆策略更新当前用户或 Peer 的记忆。它内置的记忆类型也不只包含用户偏好,还包括实体、事件、助手身份、执行轨迹、经验、工具和 Skills 等。
于是,Agent 保存的不只是“用户喜欢什么”,还可以沉淀“这次任务是怎么完成的”“哪个工具真正有效”“哪条路径已经走不通”“下次遇到类似问题应该从哪里入手”。
这些信息单独看,也许只是一次任务里的边角料;放到长期协作里,却可能是后来者少走弯路的路标。一次排查的顺序、一次方案的取舍、一次工具调用的结果,都是经验留下的纹理。
一个典型的研发协作场景是:群聊里的 Agent 处理 PR Review,Claude Code 在 CLI 里分析代码,飞书文档继续整理结论。几个入口各有分工,但如果背后能读取同一份项目资源和长期记忆,任务就不必每次都从头说起。
这不是要求所有工作都交给同一个 Agent,也不是把所有上下文都堆进同一个会话里。
它解决的是换入口之后,背景资料不用重新搬运,历史判断不用反复解释,已经走过的弯路不用再走一遍。
不过,记忆能自动沉淀,并不代表可以自动成为规范。自动提取减少了手工整理,但抽取结果仍可能有偏差。涉及发布规则、权限要求、架构决策和生产变更时,最好让写入内容可追踪、可检查、可回溯。
临时讨论可以成为线索,但不能直接变成铁律;一次经验可以留下余脉,但进入长期记忆之前,仍要经得起复看和校验。
不是纸上谈兵,而是本地云端皆可落地
机制讲清之后,接下来回到安装与验证,看看它在本地如何跑起来。
OpenViking 当前要求 Python 3.10 及以上,支持 Linux、macOS 和 Windows。官方 Quickstart 提供了两种启动方式:一种是通过 Python 包安装,作为本地命令和库使用;另一种是通过 Docker 启动,作为独立服务运行。
如果只是本地体验,可以先用 Python 包安装:
1 | uv tool install openviking --upgrade |
也可以使用 pip:
1 | pip install openviking --upgrade --force-reinstall |
安装完成后,会得到客户端命令 ov,以及服务端命令 openviking-server。首次使用建议先初始化配置,并执行一次环境检查:
1 | openviking-server init |
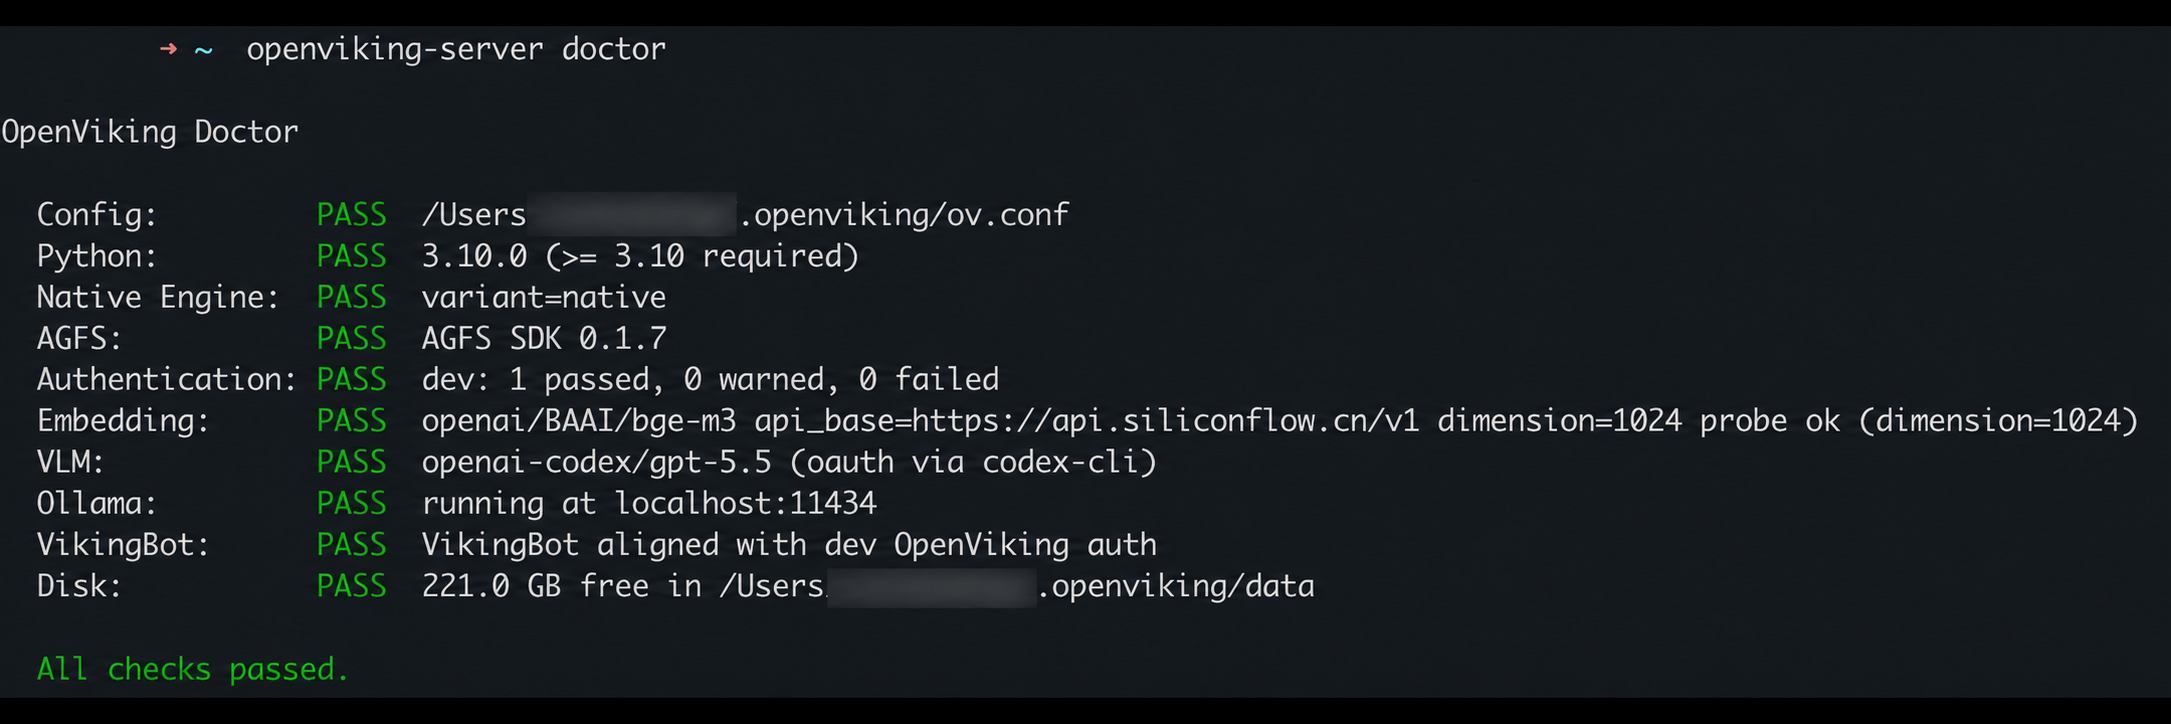
init 会引导配置模型和服务提供方,默认把配置写到 ~/.openviking/ov.conf;doctor 则用来检查 Python 版本、配置、模型连接和磁盘空间。一个负责立规矩,一个负责验环境,先把地基打稳,再往上接 Agent。
OpenViking 还需要准备两类模型能力:VLM 模型用于图像和内容理解,Embedding 模型用于向量化和语义检索。官方文档中列出的模型服务包括火山引擎、OpenAI 模型、OpenAI Codex,以及其他兼容 OpenAI API 格式的自定义模型服务。
这里有一个容易漏掉的边界:本地部署不等于数据完全不出本机。如果 VLM 或 Embedding 接的是云端 API,资源内容仍可能在处理过程中发往对应模型服务。
配置完成后,就可以启动本地服务:
1 | openviking-server |
服务保持运行后,可以在另一个终端或脚本里连接本地 Server,继续导入资源、查看目录、读取摘要和执行语义搜索。到这一步,OpenViking 才算真正从文档走到本机,从概念落到命令行。
如果希望把它作为独立服务运行,也可以使用 Docker Compose。官方示例会把服务映射到 1933 端口,并把配置和工作区数据挂载到 ~/.openviking 目录下。容器启动后,默认会提供 OpenViking API 服务,也会在 /studio 提供 Web Studio 前端。
1 | services: |
Mac 本地用 Docker 访问时有一个细节要注意:OpenViking 默认为了安全只监听 127.0.0.1,宿主机直接访问可能遇到连接问题。官方文档给出的推荐方案,是通过 socat 做端口转发。
这些步骤看起来琐碎,却很有必要。上下文服务一旦进入团队环境,问题就不只是“能不能跑起来”,还包括服务访问、模型配置、数据目录和权限边界。
先在本地把路走通,后面接 Agent、接资源、接团队流程,才不至于边走边补、顾此失彼。
不是只跑命令,而是界面、命令、代码皆可达
服务跑起来之后,第一次验证 OpenViking,可以从三条路径入手:Web Studio 看全貌,CLI 跑流程,SDK 做集成。
Web Studio 适合先做直观检查。启动 openviking-server 后,在浏览器打开:
1 | http://127.0.0.1:1933/studio |
进入页面后,可以先查看连接状态,再进入资源页面导入 README、项目文档或网页资源。处理完成后,沿着 viking:// 目录树查看资源是否归位,并检查 Abstract、Overview 和 Detail 是否正常生成。如果要验证召回效果,可以在检索页面输入问题,看结果是否能定位到对应的 URI 和原始内容。
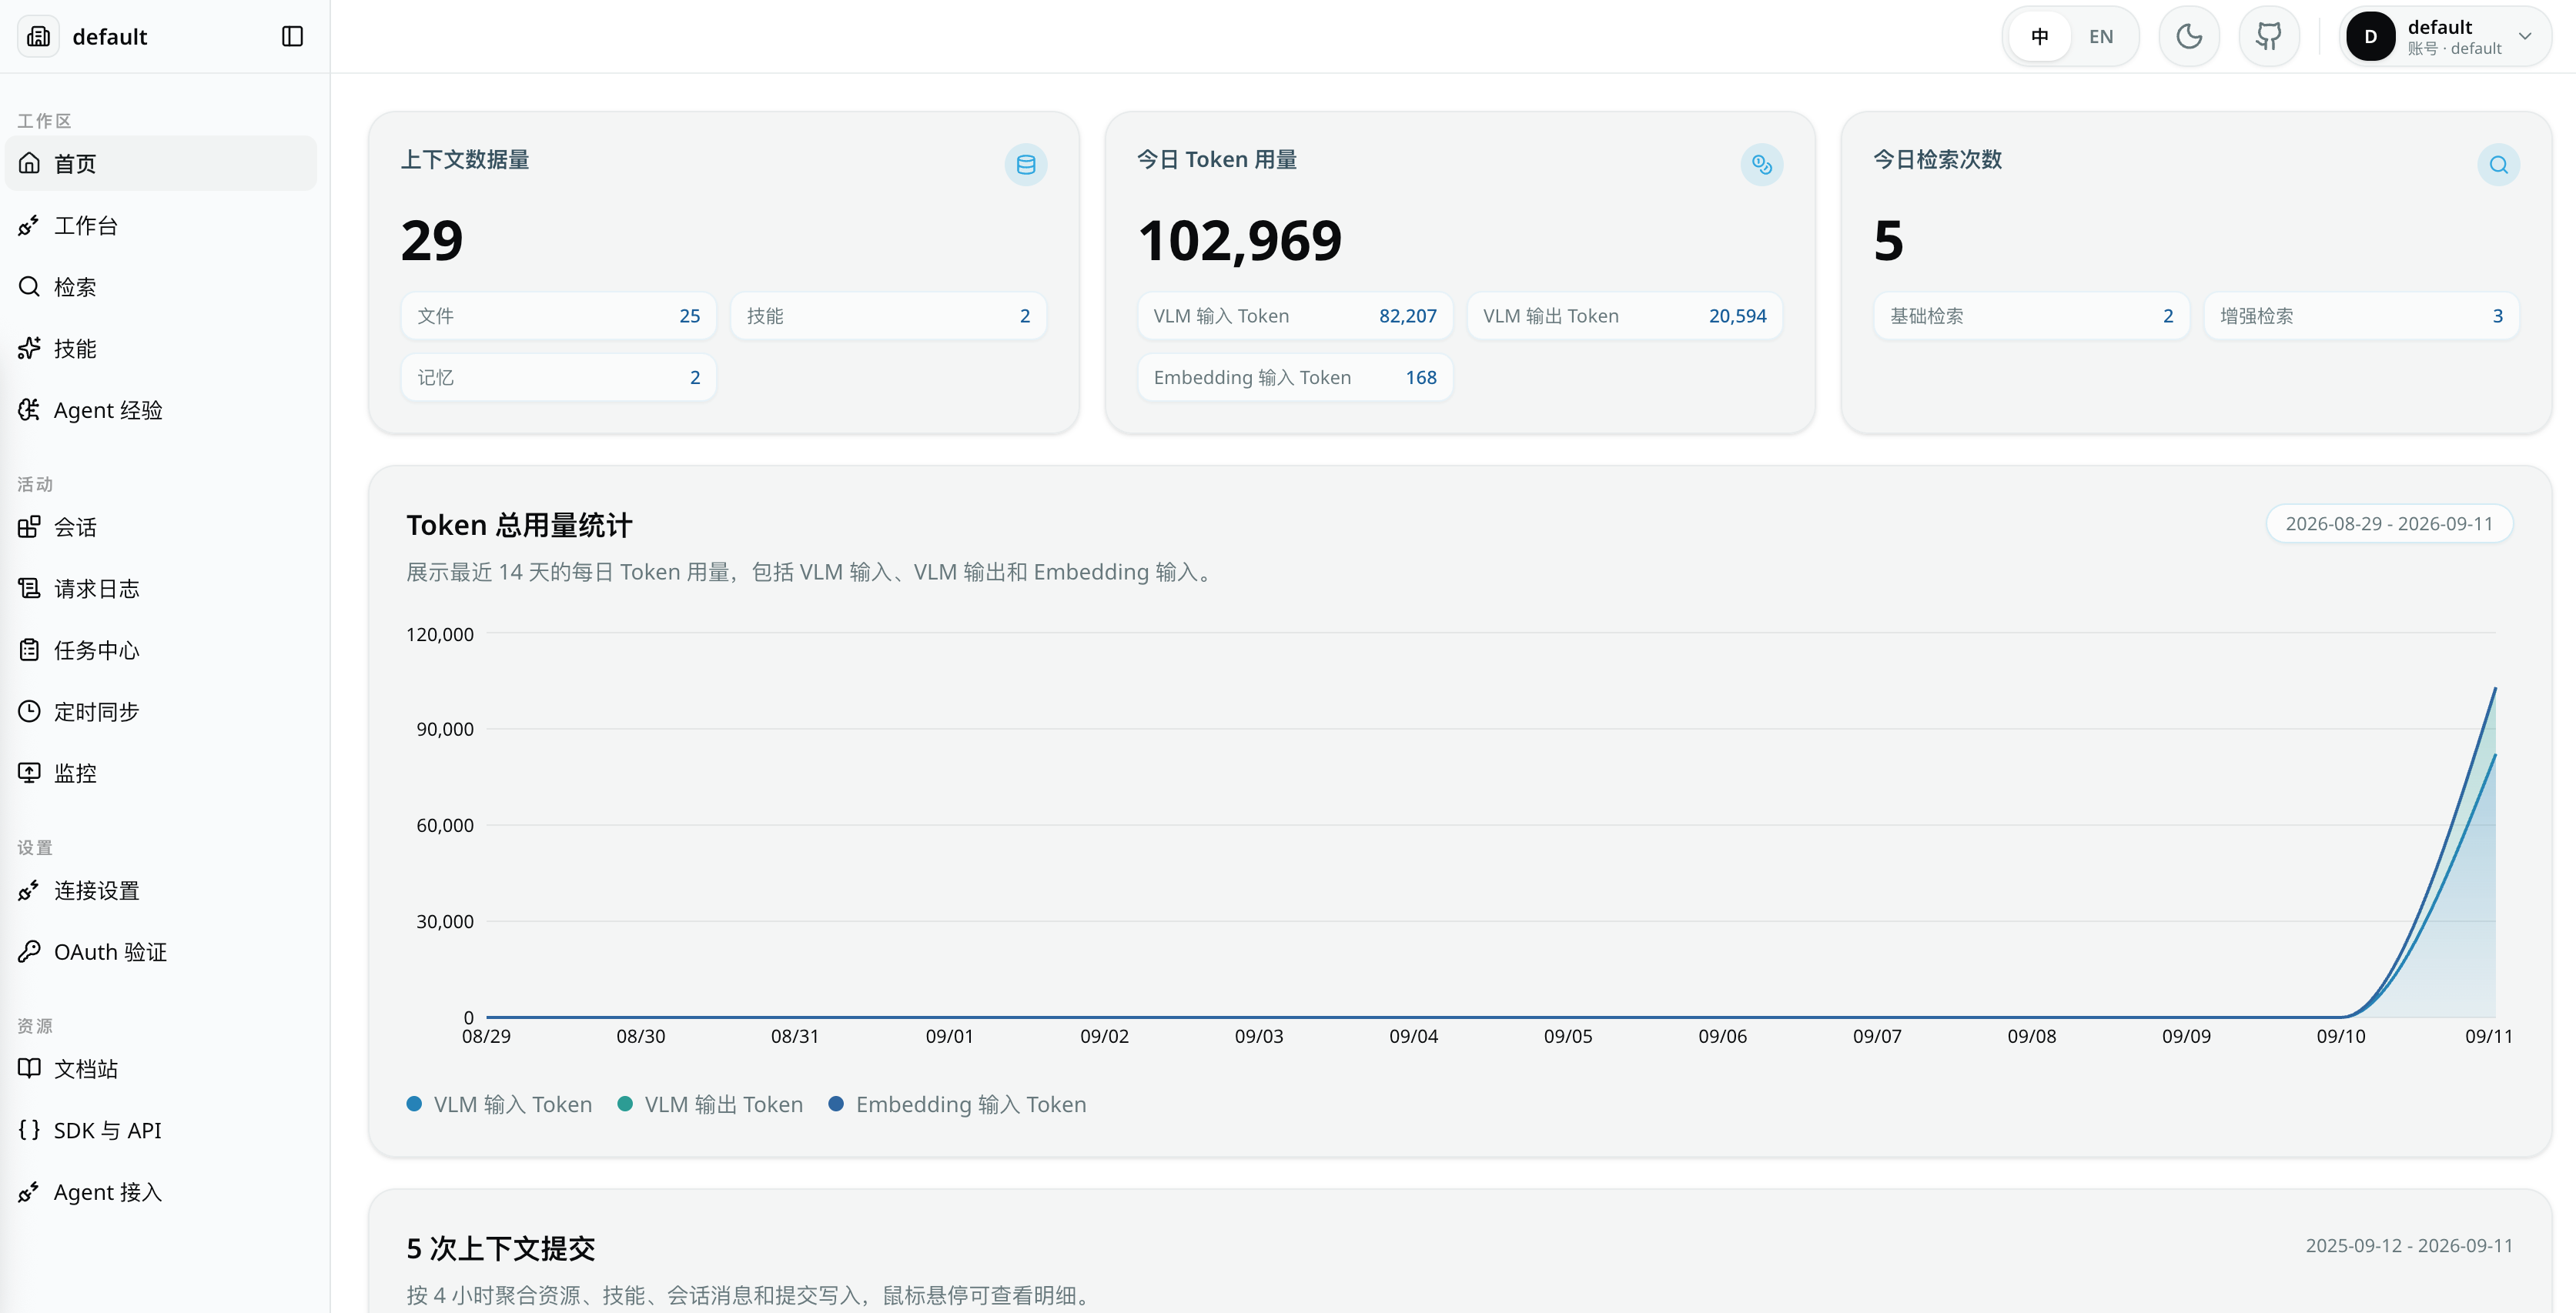
这张图主要用来确认服务状态和资源入口;真正导入资源时,还要进入 Add Resource 页面,检查资源类型、路径和处理状态是否符合预期。
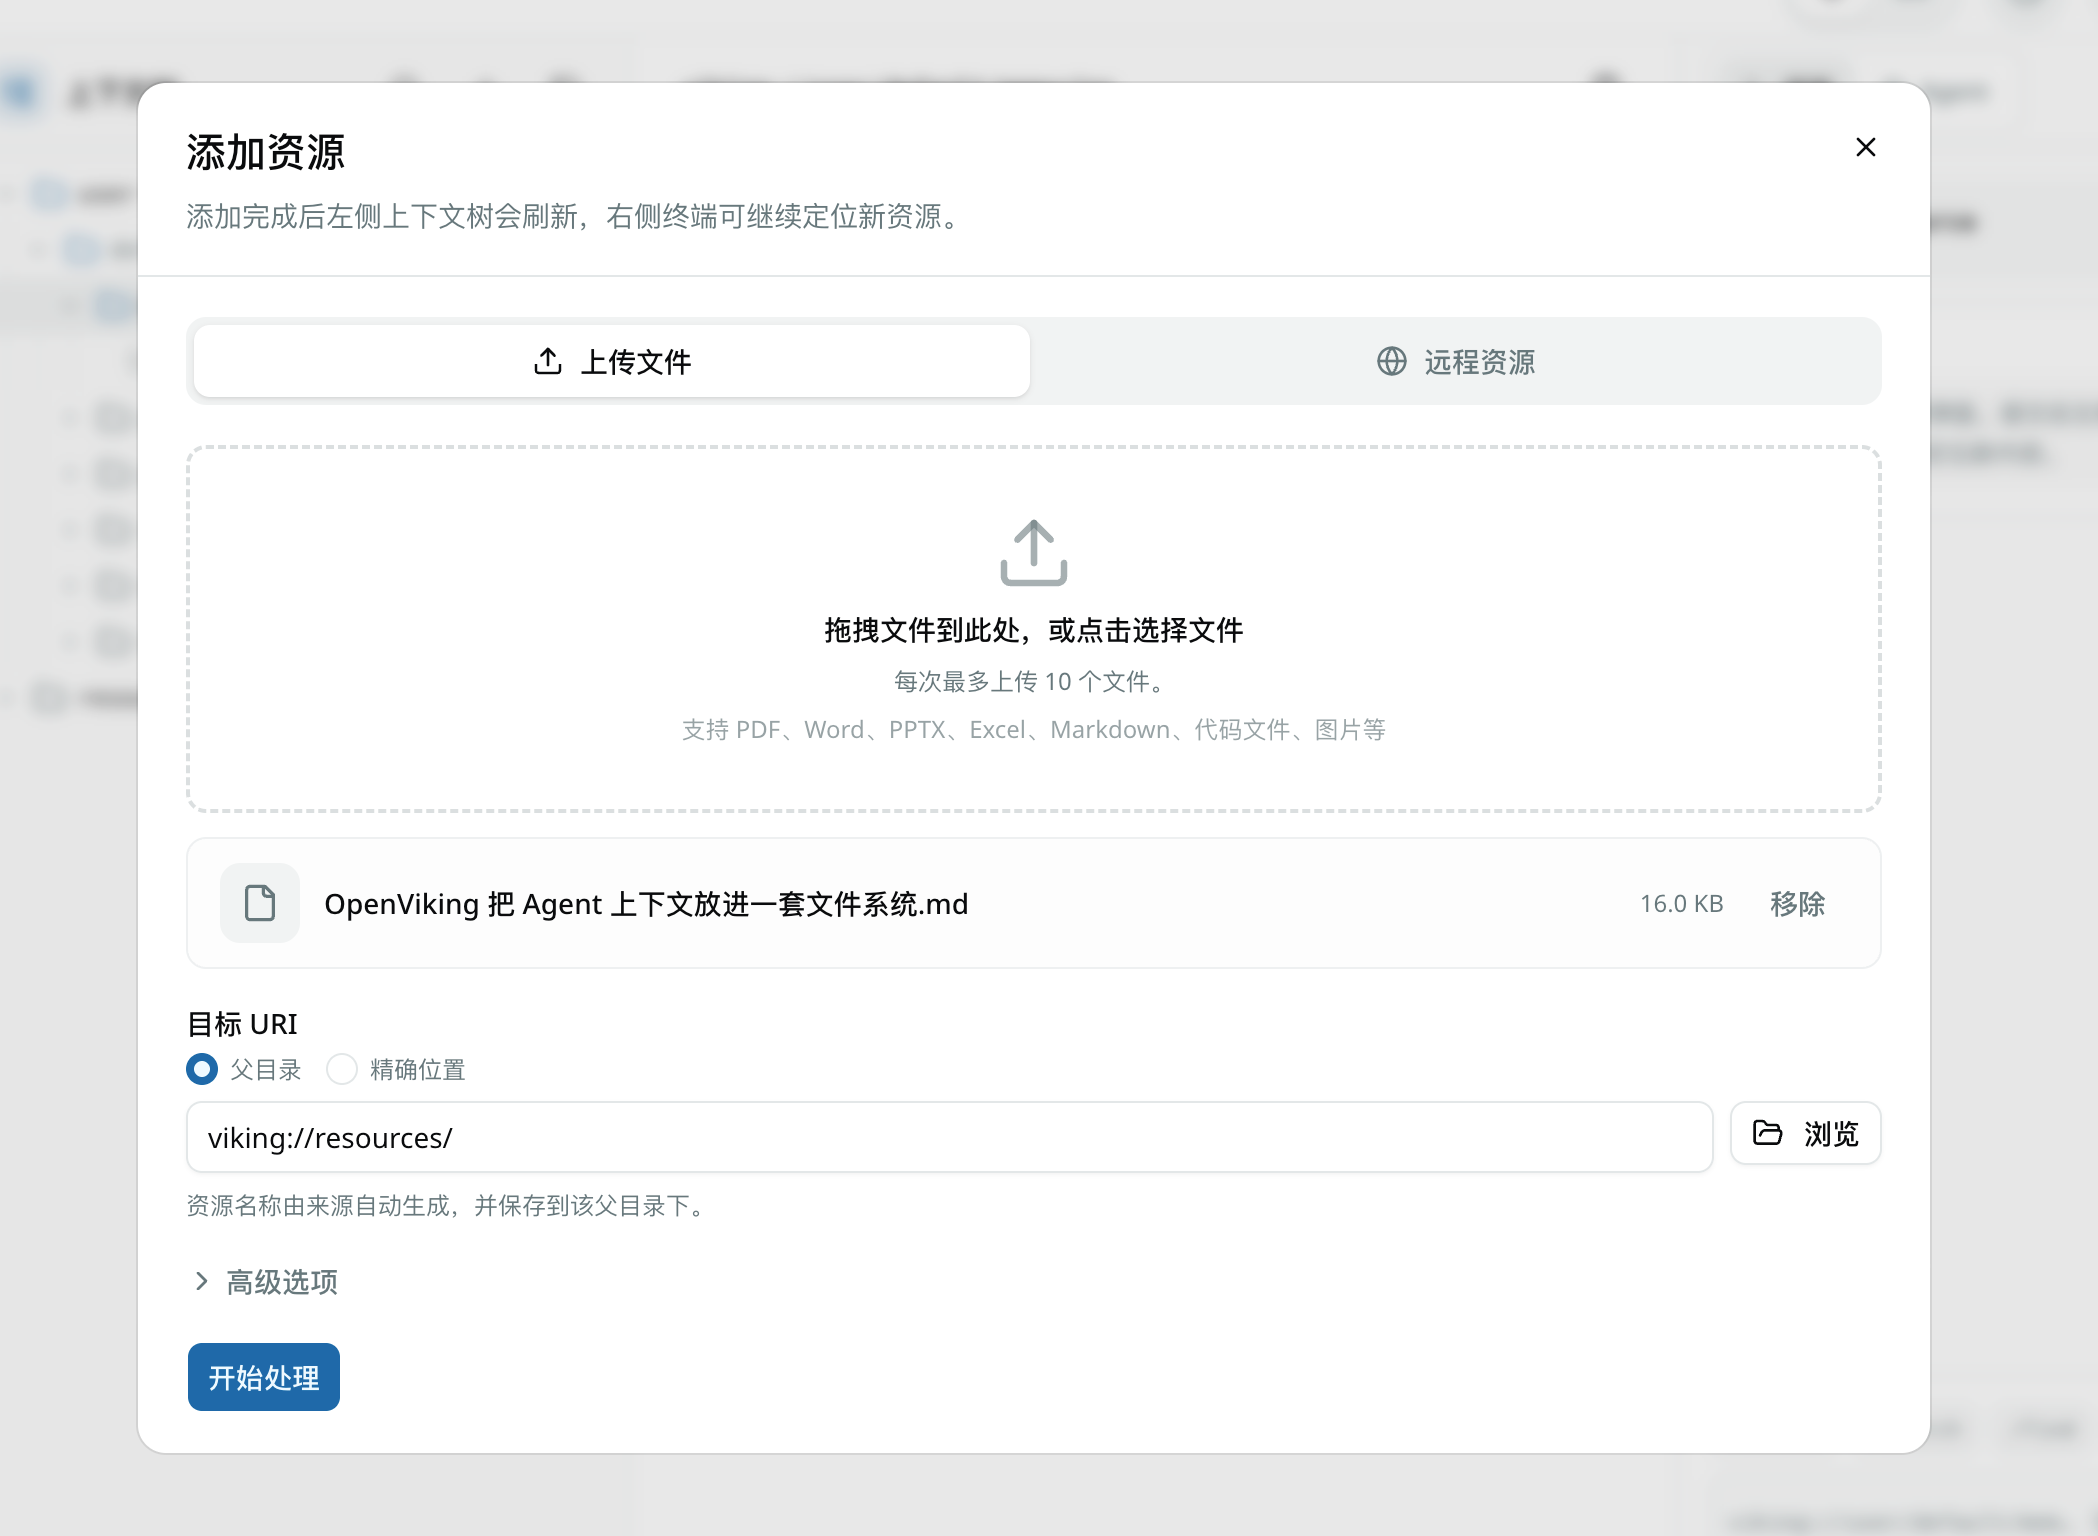
CLI 更适合日常验证和排查。常用命令可以先记这一组:
1 | # 查看服务状态 |
SDK 则适合后续接入自己的程序或业务流程。等 Web Studio 和 CLI 都确认正常后,再用 SDK 完成资源导入、任务等待、目录查看、摘要读取和语义检索,会更稳妥。
不是装上插件,而是接入脉络
本地 OpenViking 跑起来之后,下一步就是把它接进 Coding Agent。以 Codex 为例,OpenViking 官方提供了记忆插件,用来给 Codex 增加持久化的跨 Session 记忆能力。
它的作用不是替代 Codex 写代码,而是接入 Codex 的工作流。会话开始时加载 OpenViking profile 和记忆索引;用户输入前自动召回相关记忆;每轮对话结束后增量捕获新的上下文;上下文压缩前提交完整记录;正常退出会话时,再触发一次 Session Commit。
与此同时,插件也会把 Codex 连接到 OpenViking 的 /mcp 端点,让模型可以主动调用 find、search、read、remember 等工具。这样一来,记忆不再只是静静躺在后台,而是能在任务推进中被查找、被读取、被补充。
官方推荐的安装方式,是直接运行共享安装脚本。Claude Code 和 Codex 共用同一个脚本,安装过程中会依次询问界面语言、要安装的 Harness、下载源和 OpenViking 凭据。脚本是幂等的,重复执行也相对安全。
1 | bash <(curl -fsSL https://raw.githubusercontent.com/volcengine/OpenViking/main/examples/memory-plugin-shared/install.sh) |
如果 GitHub 访问不稳定,也可以使用火山引擎 TOS 镜像运行同一个安装脚本:
1 | bash <(curl -fsSL https://ovrelease.tos-cn-beijing.volces.com/memory-plugin-shared/install.sh) |
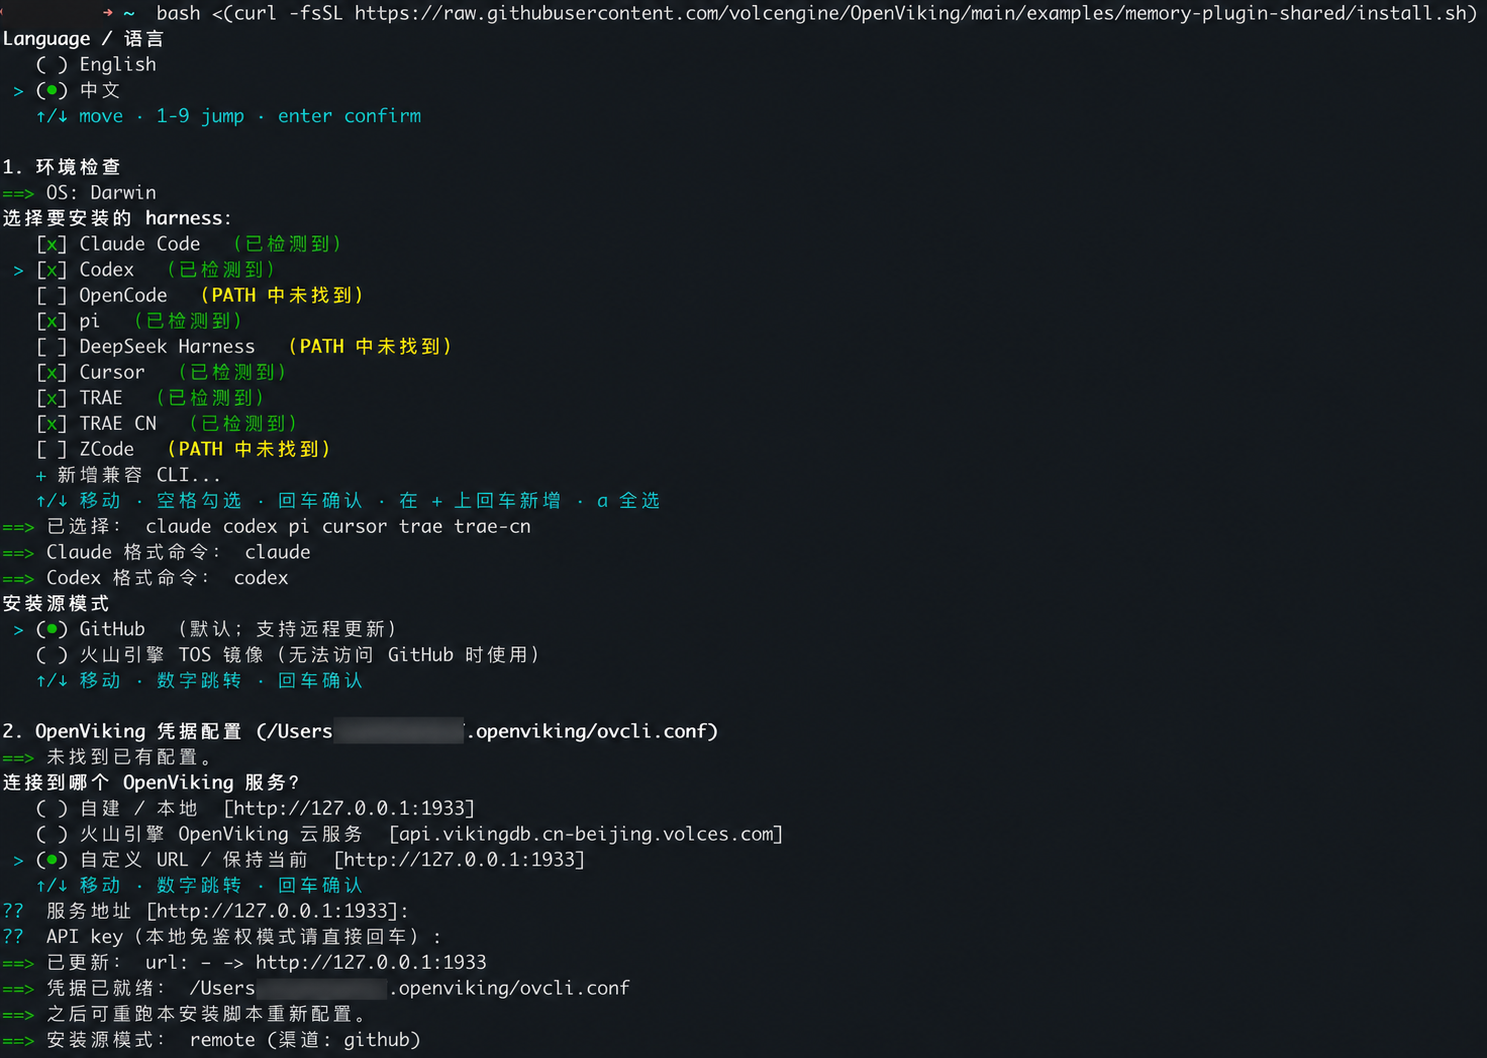
安装完成后,直接启动 Codex:
1 | codex |
首次启动后,需要在 Codex 中进入 /hooks 完成审批:
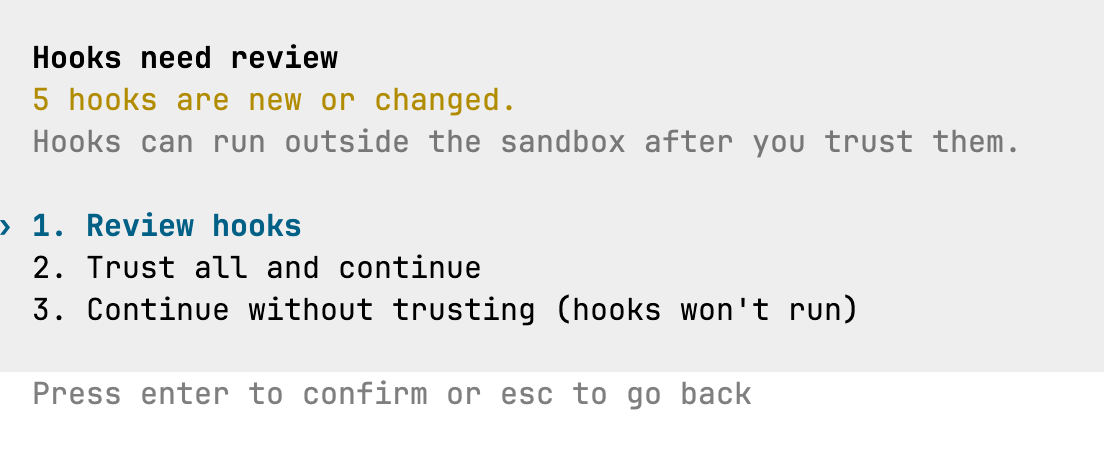
这一步看似只是授权,实际上是在确认 OpenViking 能不能介入 Codex 的关键生命周期。没有完成审批,相关 Hook 就不会按预期工作,自动召回、上下文捕获和 Session Commit 也就无从谈起。
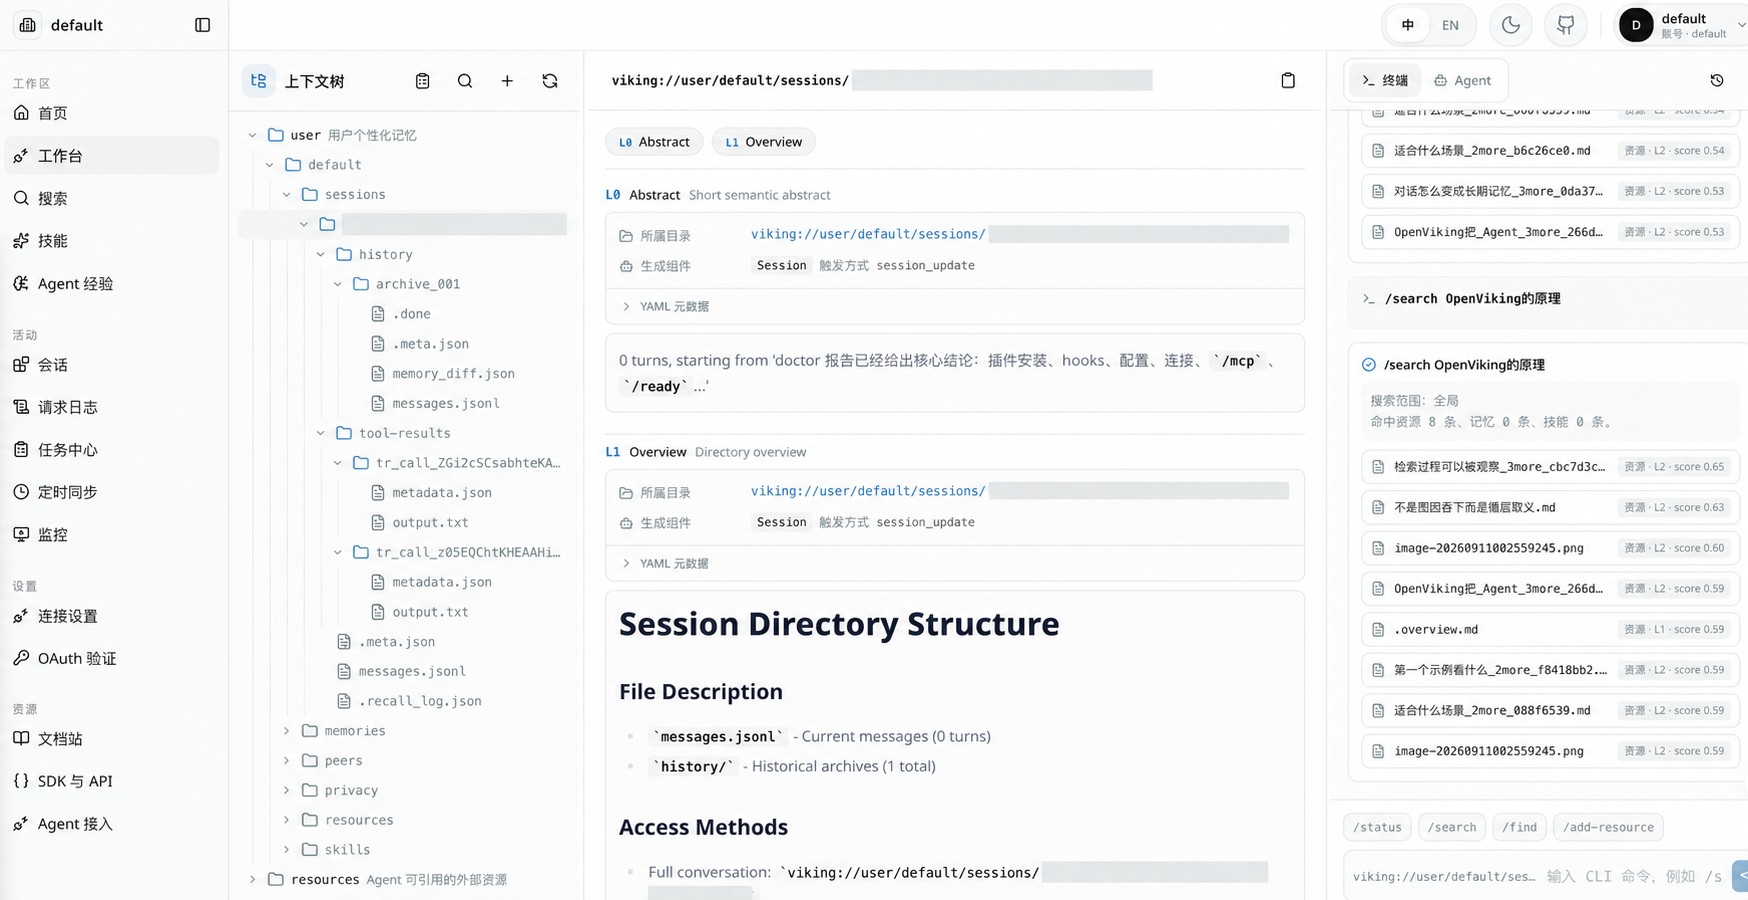
提交后的会话可以先看归档是否生成,再进入详情页确认摘要、执行轨迹和可检索内容是否补齐。
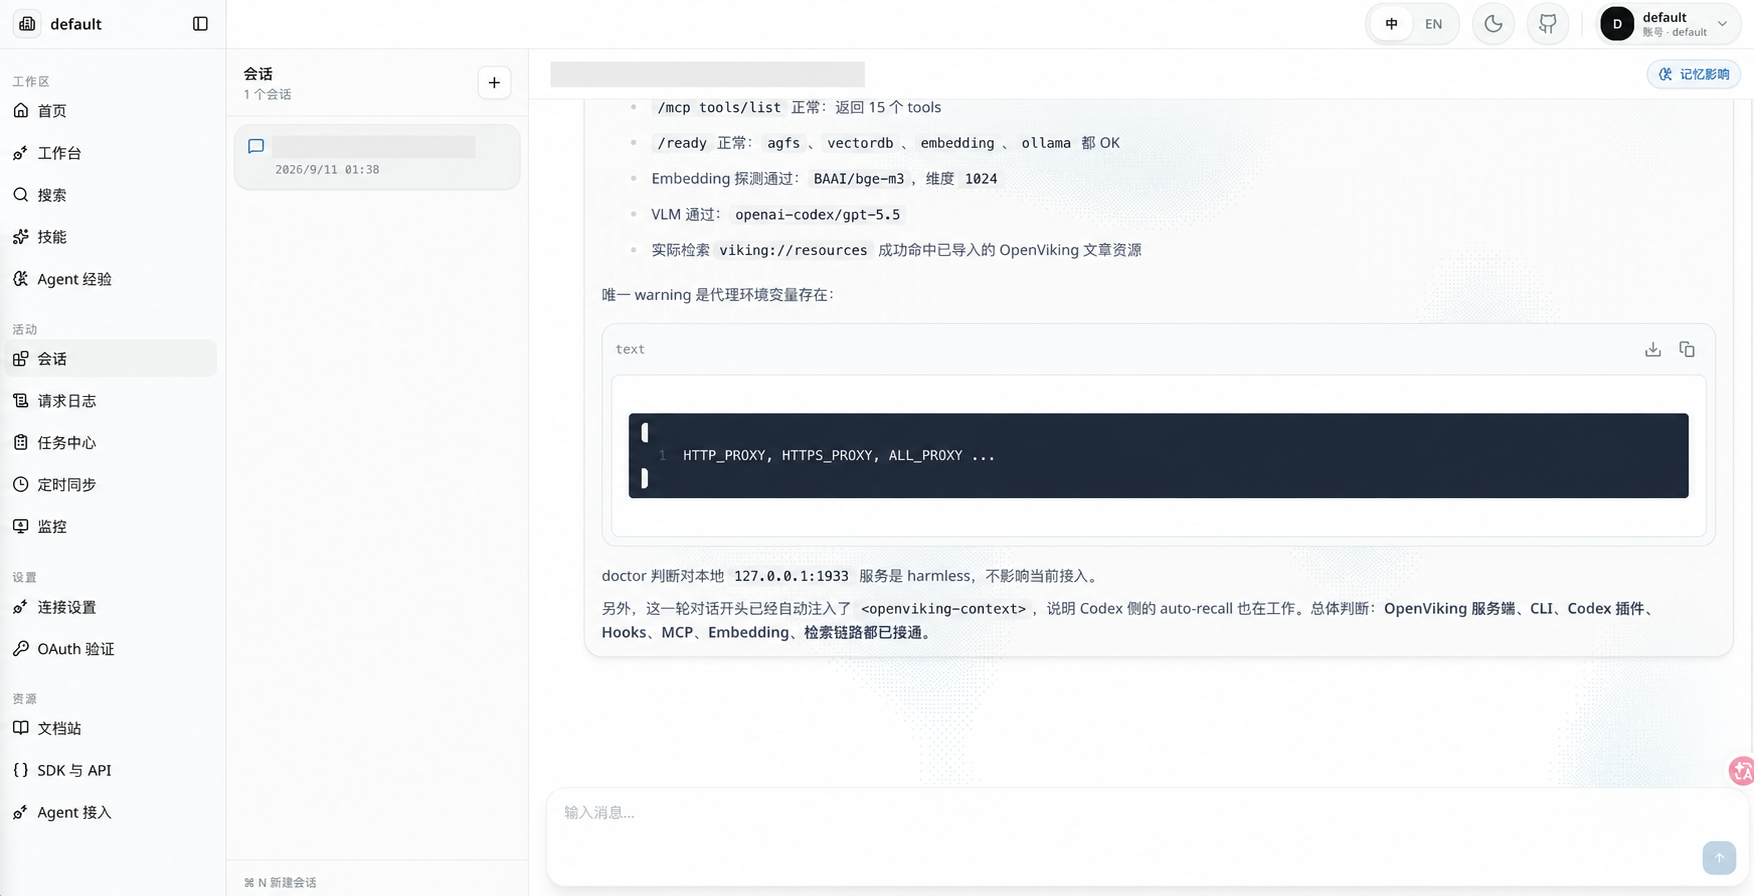
不是孰优孰劣,而是各有归途
聊完 RDS ContextDB,再看 OpenViking,会发现它们解决的是同一个大问题:Agent 的上下文不能只停留在一次会话里。
只是两者的落点不同。
ContextDB 更像是在回答“经验如何沉淀”。它关注 Agent 在任务中产生的事实、判断和反馈,如何进入长期记忆,再经过整理、审核和晋升,变成团队可以复用的知识。
它更强调企业场景里的治理闭环:能记住,也要能筛选;能入库,也要能评审;能复用,也要能控制边界。
OpenViking 更像是在回答“上下文如何组织”。它把 Resource、Memory 和 Skill 放进一套 viking:// 虚拟文件系统里,让 Agent 不只是拿到几个相似片段,而是能沿着目录逐层查找:先看摘要,再看概览,最后再读细节。
它更强调研发视角里的路径感:资料有归处,记忆有脉络,检索有轨迹。
如果说 ContextDB 更像一套企业知识治理系统,把一次次任务里的经验从个人记忆推向团队沉淀;那么 OpenViking 更像一座上下文书架,把散落在代码、文档、网页和工具里的资料重新归位,让不同 Agent 有路可走、有据可查。
二者不是简单的谁替代谁,而是各有侧重。
ContextDB 适合关注企业级记忆沉淀、知识晋升、权限隔离和审核治理的场景。
OpenViking 适合关注上下文组织、多 Agent 共享路径、检索可观测和文件系统式管理的场景;既可以用于本地验证,也可以作为服务部署到云端或团队环境中。
我的判断是,选型时不要只看“谁能记住更多”,而要看团队真正缺的是哪一环。
如果问题是经验散在个人和会话里,缺少审核后沉淀为团队知识的机制,那 ContextDB 更贴近。
如果问题是资源、记忆和 Skills 分散在不同入口里,Agent 不知道该去哪里找,那 OpenViking 的文件系统思路会更顺手。
上下文工程走到最后,拼的不是把信息堆得多满,而是让信息各归其位、来去有踪。
能沉淀,经验才不会烟消云散;能组织,知识才不会散落四方。让 Agent 记得住、找得到、用得上,还能被检查和更新,才是这两类上下文服务真正想补上的一课。